这篇写什么?
做 Soundbar、音箱、车机、智能助手时,口头常蹦出一串缩写:KWS、ASR、STT、TTS、VAD、AEC……很容易混。
本文只做一件事:把「听 → 懂 → 说」的整体链路讲清楚;并说明每个缩写在工程里常出现在哪一层。站内已有更细的唤醒 / Mic+Ref / 测试文,文末会指路。
整体链路(先看这一段)
别人对你说一句话,设备大概会走:
- 麦克风采到声音波形
- **前端处理(AEC / NS / 波束)**去掉喇叭回声和环境噪声,让人声更干净
- VAD判断:现在有没有人在说话?
- **KWS(语音唤醒)**判断:是不是在叫我?(例如「小爱同学」)——没叫就不往下走,省电
- **ASR / STT(语音识别)**把后面整句命令变成文字
- NLU / 大模型看懂文字:你想干什么?并给出回复文字
- TTS(语音合成)把回复念出来,从喇叭播放
用箭头串起来就是:
麦克风采到波形
  → 前端处理(AEC/NS…)让人声更干净
  → VAD 判断「有没有在说话」
  → KWS 判断「是不是在叫我」(唤醒)
  → ASR/STT 把连续说话变成文字
  → NLU / 大模型理解并给出回复文字
  → TTS 把回复念出来,从喇叭播放
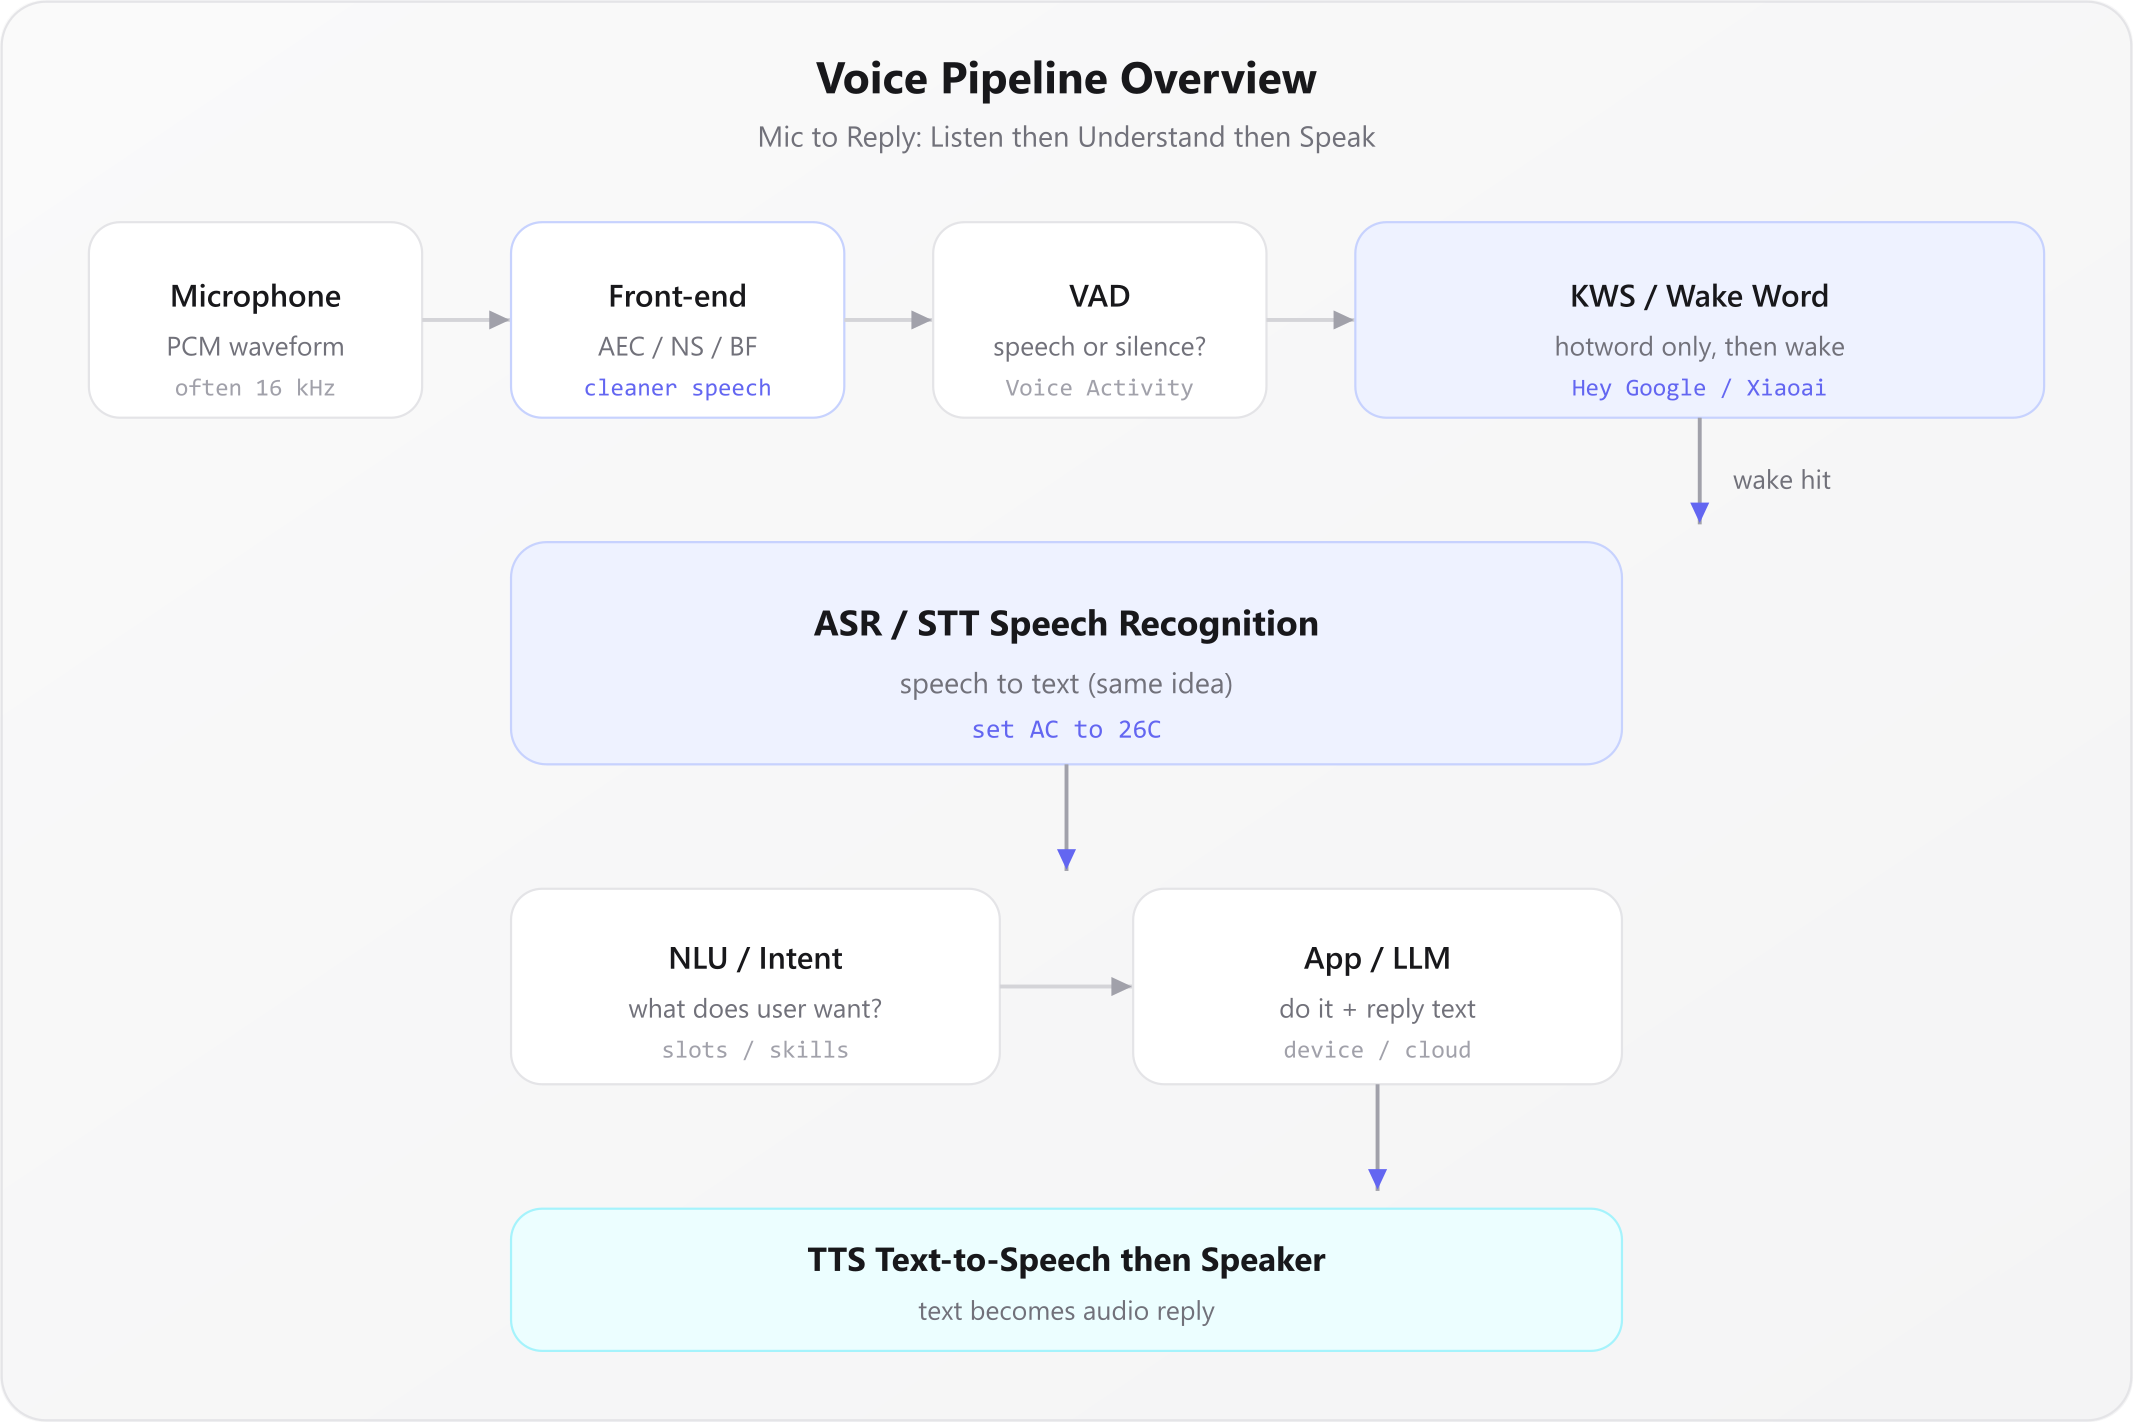
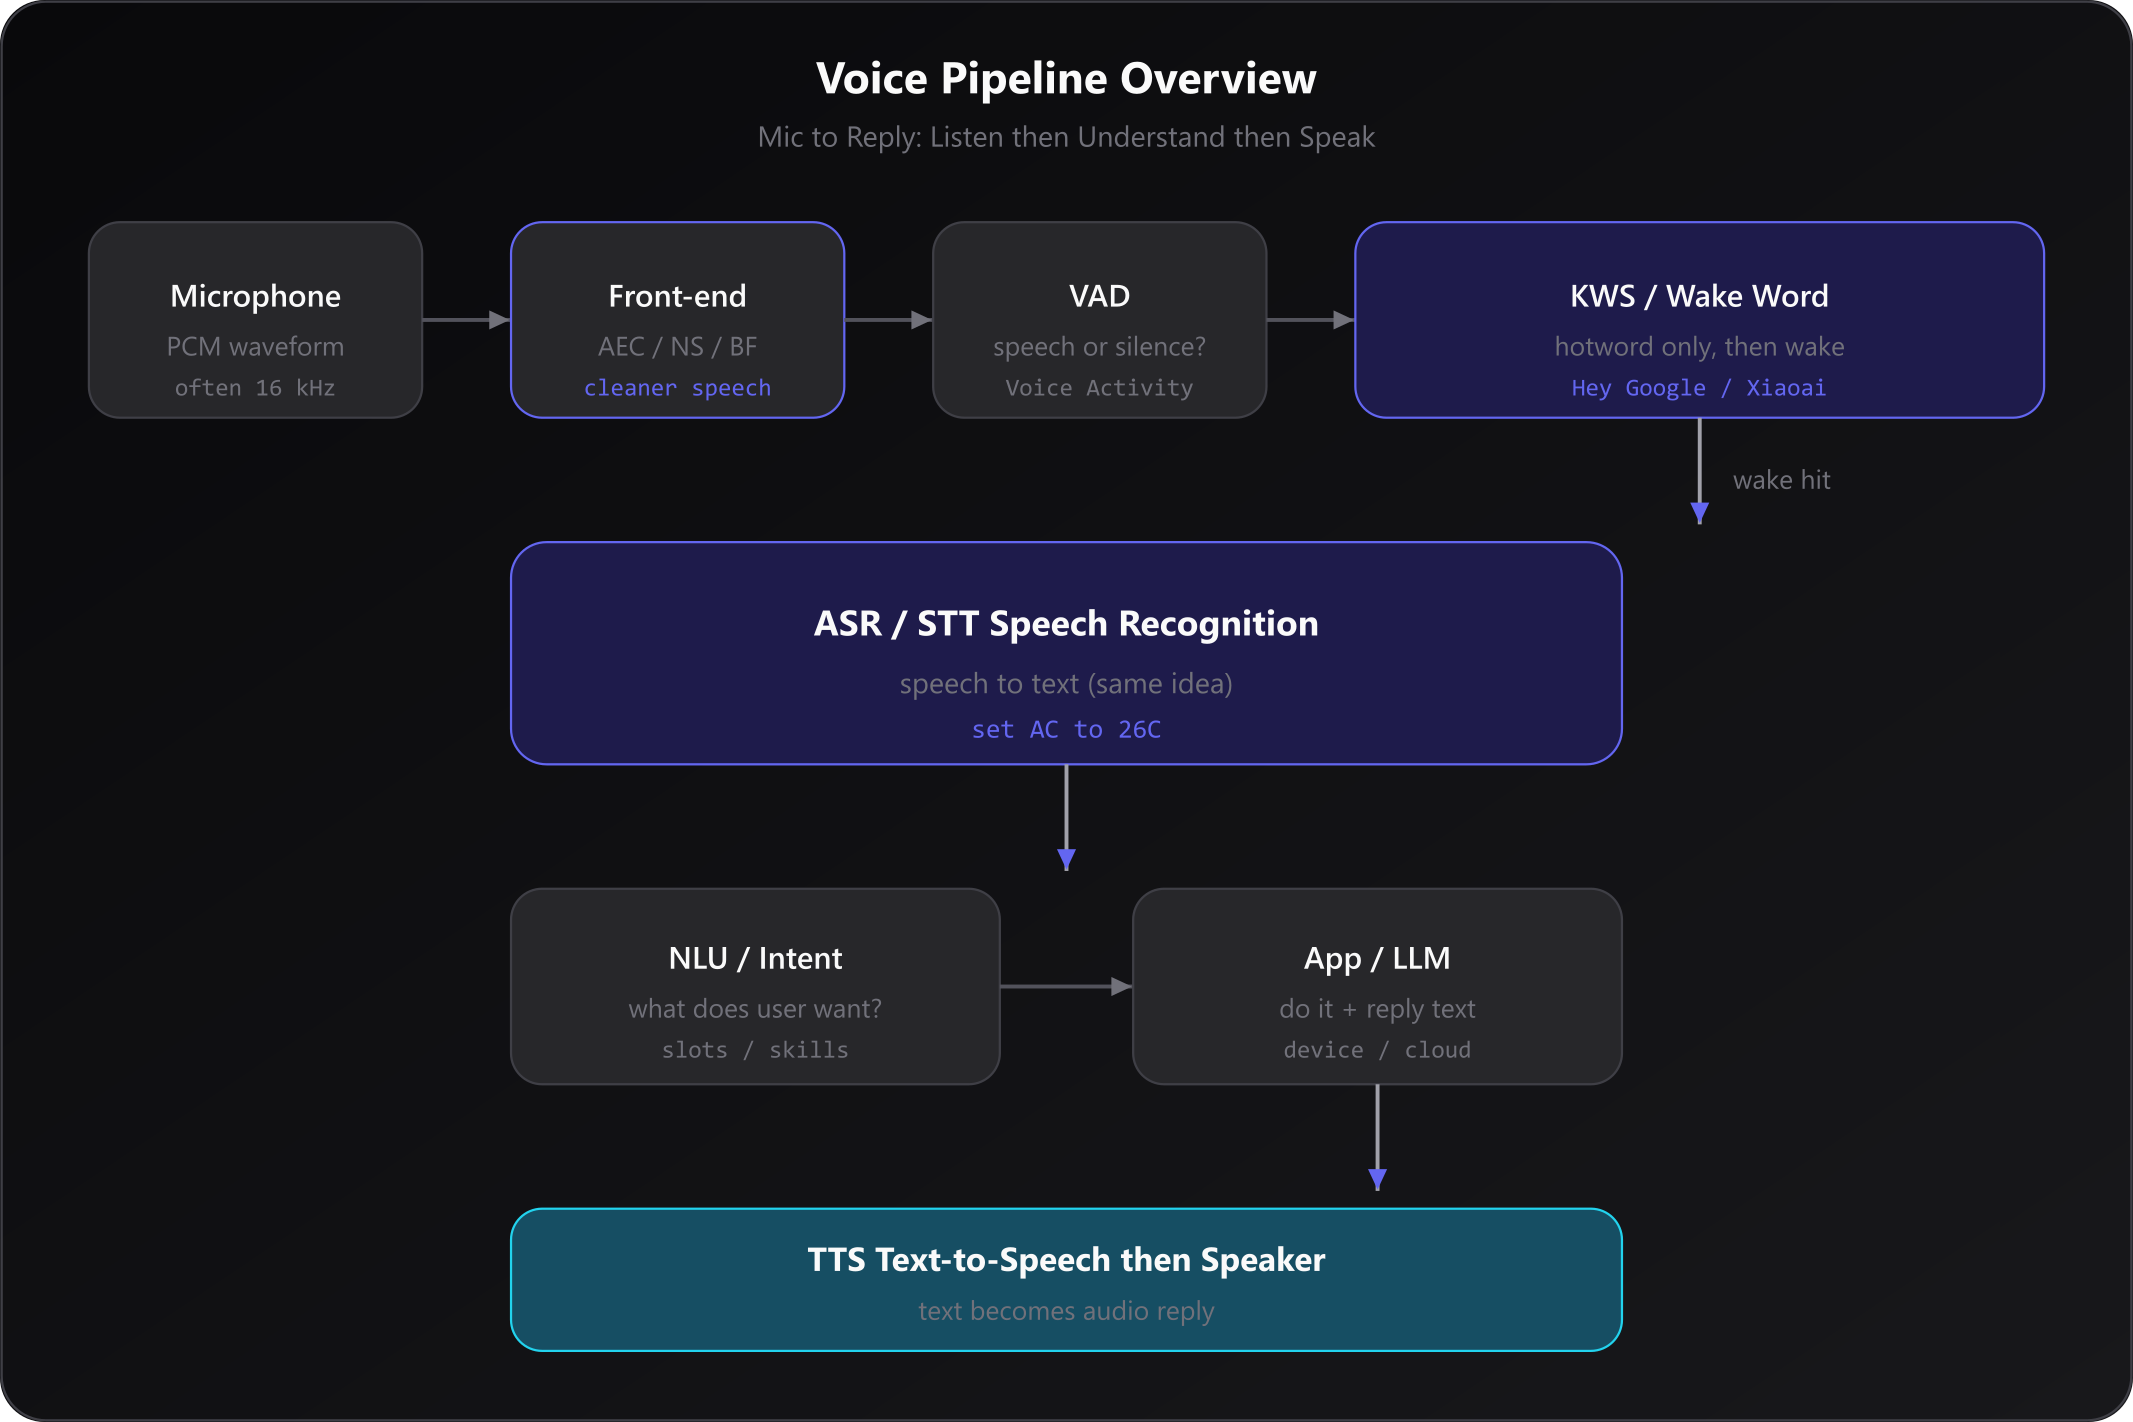
(上图:从 Mic 到 TTS 的完整流水线。深色主题会自动换暗色版。)
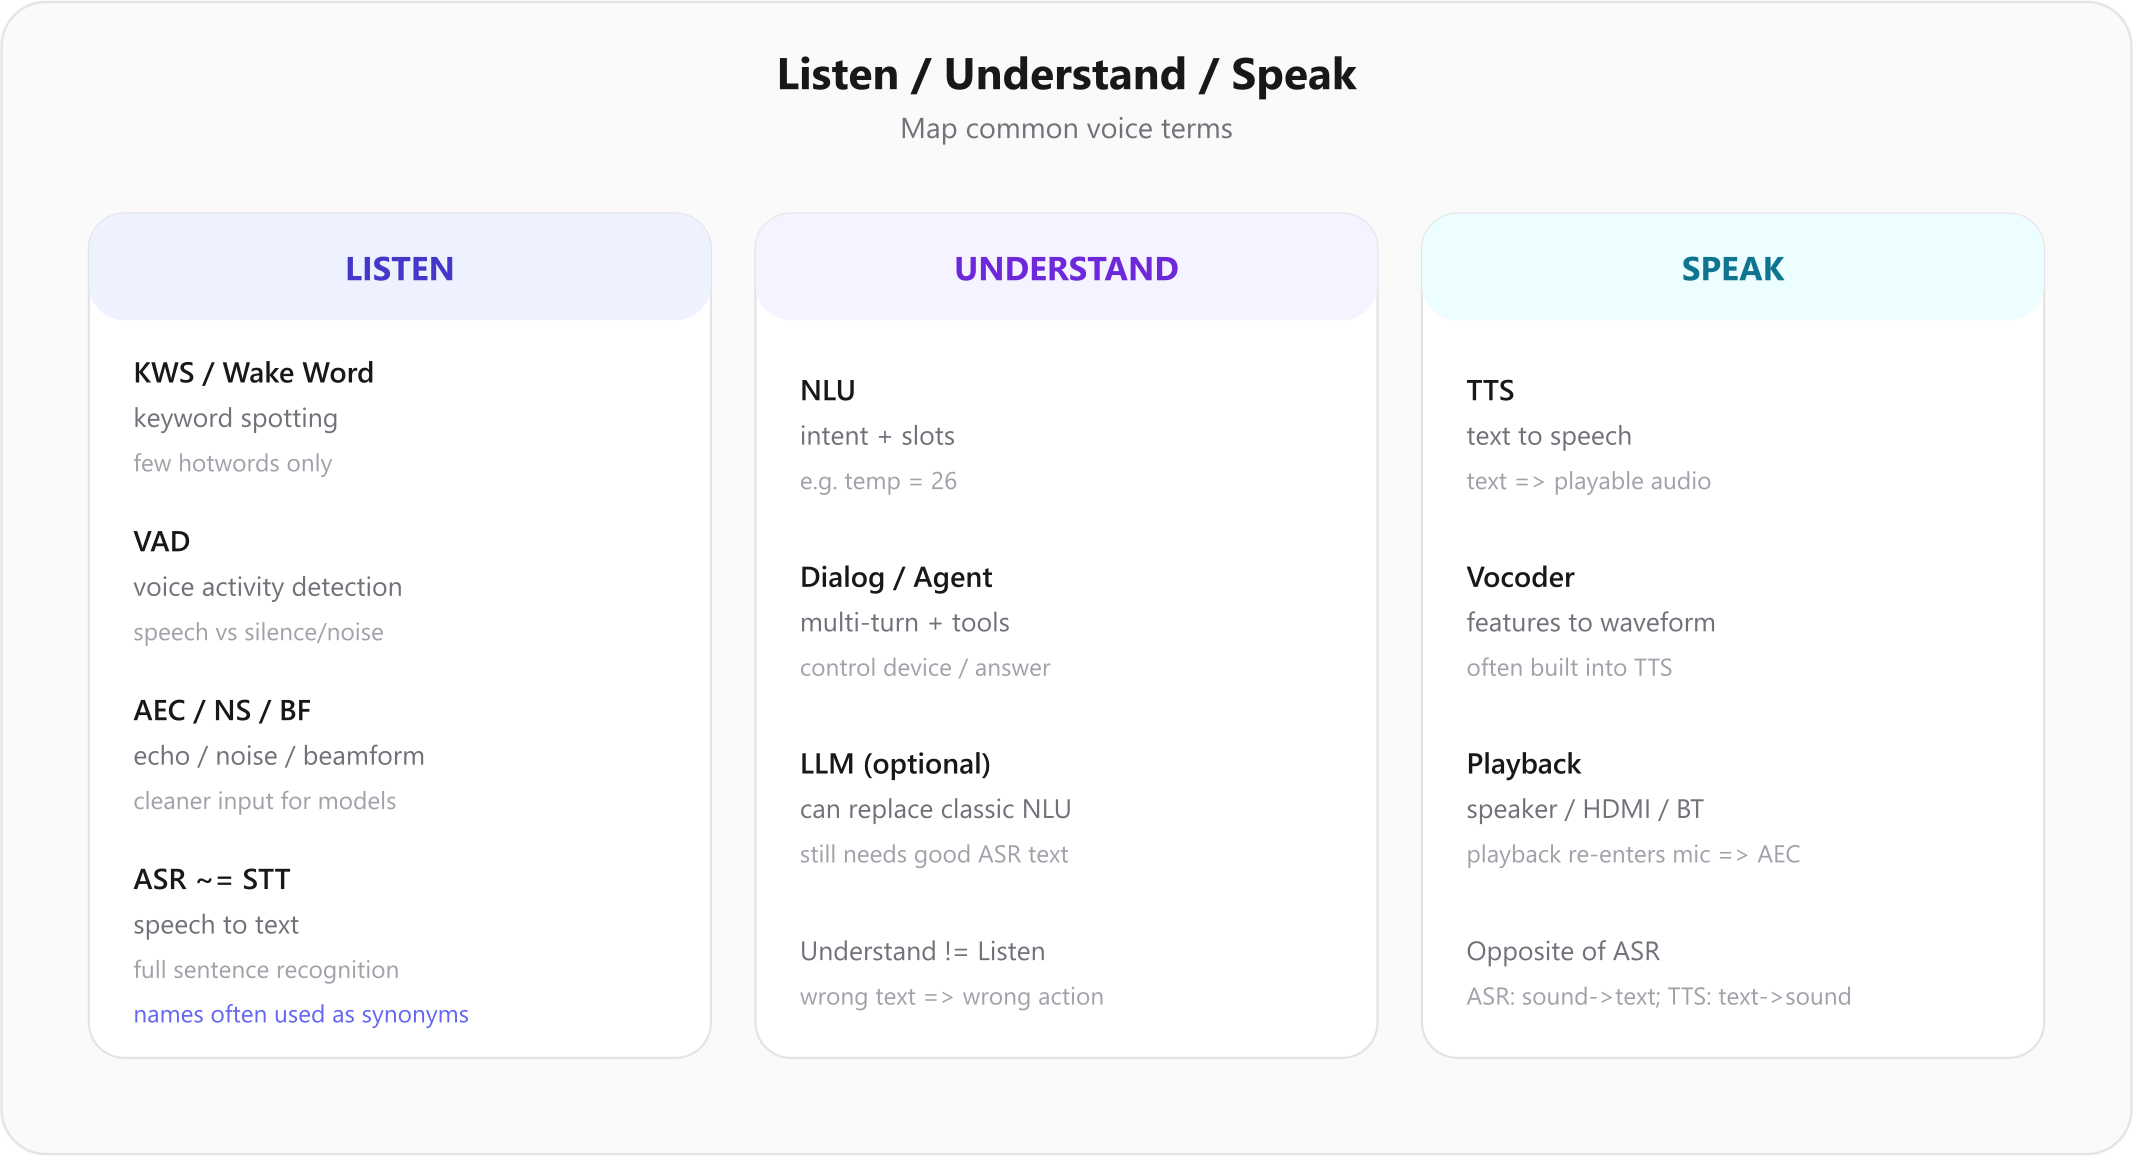
一、先分清:听、懂、说
整条链路可以压成三件事:
| 方向 | 常见名字 | 人话 | 在链路里的位置 |
|---|---|---|---|
| 听 | KWS / Wake Word | 只盯几个热词,听到才「醒」 | 第 4 步 |
| 听 | VAD | 区分「在说话」还是静音/噪声 | 第 3 步 |
| 听 | AEC / NS / BF | 消回声、降噪、波束,让后面更好听 | 第 2 步 |
| 听 | ASR ≈ STT | 把一整句说话变成文字 | 第 5 步 |
| 懂 | NLU / Dialog / LLM | 理解意图、执行、生成回复文字 | 第 6 步 |
| 说 | TTS | 把文字合成声音再播放 | 第 7 步 |
记住两个最容易混的:
-
ASR 和 STT 基本是一类事
- ASR = Automatic Speech Recognition(自动语音识别)
- STT = Speech-to-Text(语音转文字)
产品文档、云厂商、论文里常混用,看到哪个都按「语音 → 文字」理解即可。
-
TTS 是反方向
- TTS = Text-to-Speech(文字 → 语音)
和 ASR/STT 正好相反。
- TTS = Text-to-Speech(文字 → 语音)
所以:整体链路已经讲清了——听清(前端+VAD+唤醒+识别)→ 听懂(NLU/大模型)→ 说出来(TTS)。后面各节是对每一步的展开。
二、各模块分别干什么?
1)语音唤醒 KWS(Keyword Spotting / Wake Word)
- 目标:设备待机时几乎一直在「浅听」,但只对少数词敏感,例如「小爱同学」「Hey Google」。
- 特点:算力小、功耗低、误触发和漏触发要权衡;常跑在 DSP / 本地小模型。
- 和 ASR 的差别:唤醒只认「热词」;ASR 要认「整句内容」。
站内更深:
2)VAD(Voice Activity Detection)
- 目标:判断当前这一小段是「人在说话」还是「没说话」。
- 用途:省流量、切句、决定何时开始/结束送 ASR;唤醒前后也会用到。
- 注意:嘈杂环境、远场、音乐背景下,VAD 本身就是一道难题。
3)前端处理:AEC / NS / BF
| 缩写 | 全称(常见) | 作用 |
|---|---|---|
| AEC | Acoustic Echo Cancellation | 消掉喇叭回灌进麦的声音 |
| NS | Noise Suppression | 压环境噪声 |
| BF | Beamforming | 多麦指向说话人方向 |
音箱一边播 TTS/音乐,一边听人说,没有 AEC 时,算法听到的常是「自己的回声 + 人声糊在一起」。
相关:Soundbar THD 验证、loopback 抗混叠。
4)ASR / STT 语音识别
- 目标:连续语音 → 文字(可能带标点、时间戳、多候选)。
- 形态:云端大模型识别、端侧流式识别、或「端侧粗识别 + 云端精修」。
- 指标粗看:字错率、延迟、远场/噪声鲁棒性、方言与领域词。
唤醒成功后,常见路径是:打开更完整的录音通路,把后续命令句送给 ASR。
5)NLU / 对话 / 大模型(懂)
- 传统 NLU:意图(调空调)+ 槽位(温度=26)。
- 现在:很多产品把「懂」交给 LLM / Agent,ASR 出文字后直接进大模型。
- 关键:ASR 错一个字,后面理解可能整段跑偏——所以声学前端和识别质量仍然重要。
6)TTS 语音合成(说)
- 目标:回复文字 → 可播放音频。
- 关注点:自然度、延迟(首包多久出声)、多音色、可控语速/情感、是否可离线。
- 和唤醒语料:训练/评测唤醒时,常用 TTS 批量生成「热词」音频——本站工具页就有唤醒语料 TTS。
三、端上一条「典型」链路(音箱 / Soundbar)
结合消费电子里常见的远场助手,可以简化成:
┌────────────── 常开、低功耗 ──────────────┐
│  麦阵 + Ref → AEC/NS → KWS(热词)        │
└──────────────────┬───────────────────────┘
                   │ 唤醒命中
                   ▼
┌────────────── 会话阶段 ─────────────────┐
│  继续取麦 →(可选)端侧 ASR 或上云 ASR     │
│  → NLU / 云端技能 / 大模型               │
│  → TTS → 喇叭播放(同时 Ref 进 AEC)      │
└─────────────────────────────────────────┘
要点:
- 唤醒前尽量省电、少上传。
- 唤醒后才拉起重识别、连网、播报。
- 播放 TTS 时系统仍可能在听下一轮——AEC 与半双工/全双工策略要设计好。
- 同一台设备可能有多路唤醒(系统远场 + 自研助手),见 多路语音唤醒。
四、本地 vs 云端,怎么选?
| 能力 | 偏本地 | 偏云端 |
|---|---|---|
| KWS | 几乎总是本地(时延/隐私/待机) | 很少纯靠云做首唤醒 |
| ASR | 离线命令、低时延短指令 | 长句、复杂领域、大词表 |
| TTS | 固定话术、弱网 | 多音色、长文本、高质量 |
| NLU/LLM | 小技能、规则 | 开放域问答、复杂推理 |
没有绝对对错:很多产品是 本地唤醒 + 云端识别/对话 + 云端或本地 TTS 的混合。
五、和 KunSpace 工具的关系
本站「在线工具」里有一批音视频能力,对应语音工程里常见的数据准备,不是完整助手,但很实用:
| 工具 | 大概对应 |
|---|---|
| 转 WAV / 批量 prep | 统一 16 kHz 单声道,方便喂唤醒/识别 |
| 唤醒语料 TTS | 用 TTS 生成热词音频,做数据与回归 |
| 网页录音 | 快速录一段测试音 |
| 波形 / 频谱 / 响度 | 听不清时先「看见」信号 |
| 剪切去静音、噪声叠加 | 造样本、压测鲁棒性 |
| 播放延迟 | 粗看通路延迟 |
进阶声学与通路:见 麦克风阵列音频检查、ALSA period/缓冲。
六、一张表速查缩写
| 缩写 | 常见中文 | 输入 → 输出 |
|---|---|---|
| KWS | 语音唤醒 / 热词 | 波形 → 是否命中热词 |
| VAD | 语音活动检测 | 波形 → 有无语音 |
| AEC | 回声消除 | Mic+Ref → 干净近讲/远场人声 |
| NS | 降噪 | 带噪语音 → 更干净语音 |
| ASR | 语音识别 | 语音 → 文字 |
| STT | 语音转文字 | 同 ASR |
| NLU | 自然语言理解 | 文字 → 意图/槽位 |
| TTS | 语音合成 | 文字 → 语音 |
| STT↔TTS | — | 互为反向 |
七、小结
- **唤醒(KWS)**负责「叫我才理你」;**识别(ASR/STT)**负责「你说的内容写下来」;**合成(TTS)**负责「我用声音回答你」。
- VAD / AEC / NS 是听清的前置条件,不是可有可无的形容词。
- ASR 与 STT 在工程交流里常当作同义;别和 TTS 搞反。
- 真机问题多半出在:麦阵与 Ref、抗混叠、回声、多路抢麦、缓冲与延迟——这些在站内实战文里写得更细。
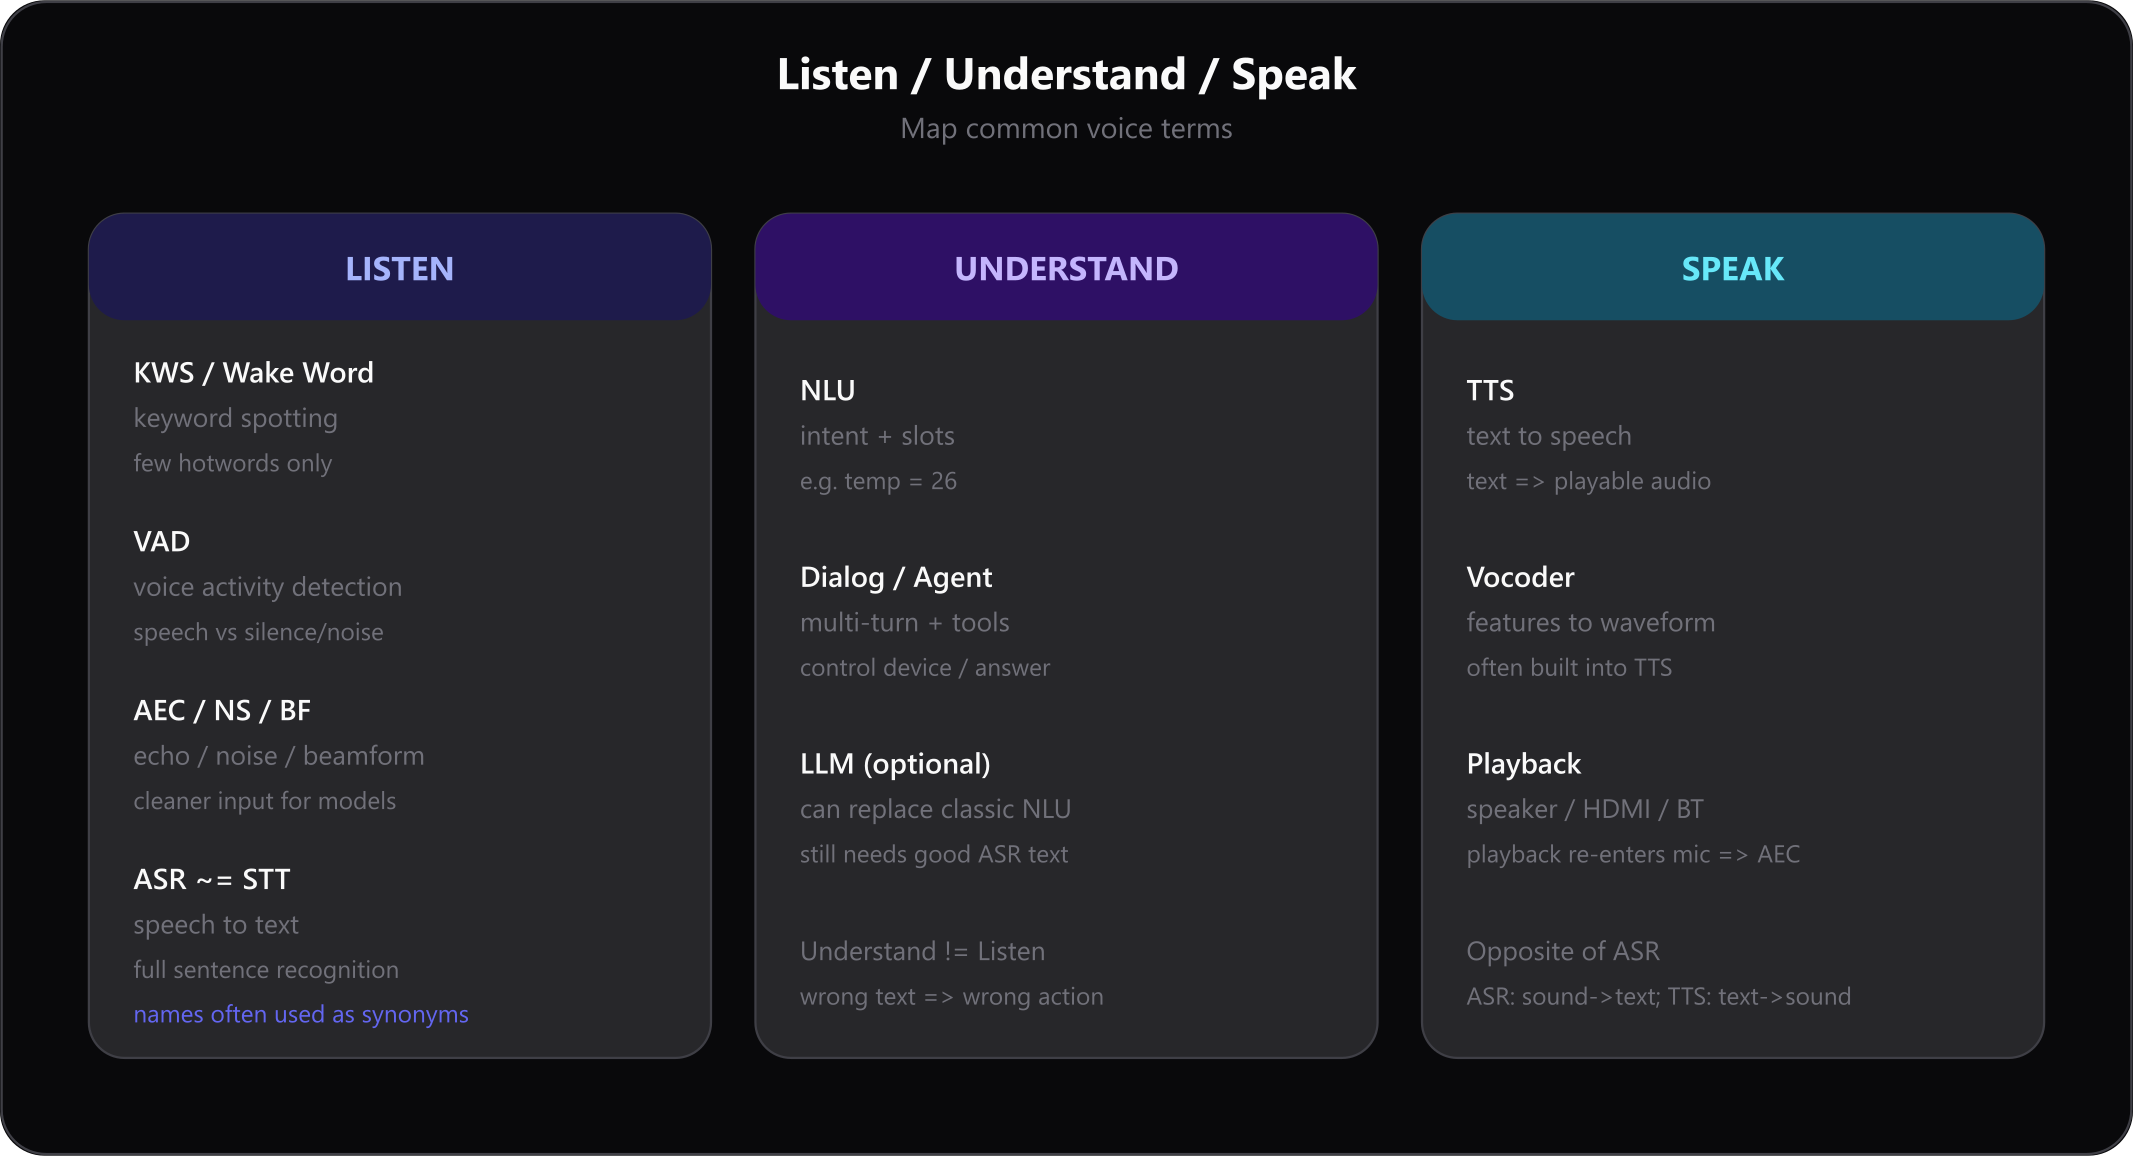
若你只记一张图:看文首「语音交互全链路」;若只记一张表:看「听 / 懂 / 说」名词图。
延伸阅读(本站)
- DSPC 专栏①:DSP Concepts 与 Sensory(TV 上 TalkTo / EQ / WWE 架构系列)
- 语音唤醒 preprocess 流程
- Google 远场与 HAL AEC
- Mic + Ref 做唤醒 / 降噪
- 多路语音唤醒
- 麦克风阵列音频检查方法与标准
- Android 音频框架概览
评论
还没有评论,来做第一个吧
赞同、吐槽、提问都行,评论区开放